Forschung im Detail
Der weitere Artikel richtet sich an alle, die sich für die technischen Details interessieren: die Verarbeitungspipeline, wie unser Thesaurus aus den Dokumenten wächst, wo die Normalisierung an ihre Grenzen stößt, wie die Aufteilung der Extraktion in zwei Schritte den Anteil der erkannten relevanten Informationen (Recall) erhöht hat, sowie zwei ausführliche Beispiele. Der Blogbeitrag wurde im Original auf Englisch verfasst.
Was die Ärzte wollten
Die Anforderung, dass das System, anstatt Antworten zu generieren, sinnvolle Belege präsentieren soll, prägte die Lösungsarchitektur stärker als die Modellwahl, die Prompts oder sogar die Suchtechnologie.
Ein Laborwert kann in zehn Dokumenten vorkommen. Eine Diagnose kann an einer Stelle abgekürzt und an einer anderen ausgeschrieben sein. Ein Medikament kann angesetzt, geändert, pausiert und später abgesetzt werden. Ein heute verfasster Arztbrief kann sich auf eine Untersuchung beziehen, die vor sechs Monaten durchgeführt wurde.
Bei vielen klinischen Fragen sind die Beziehungen zwischen diesen Informationen genauso wichtig wie die Informationen selbst.
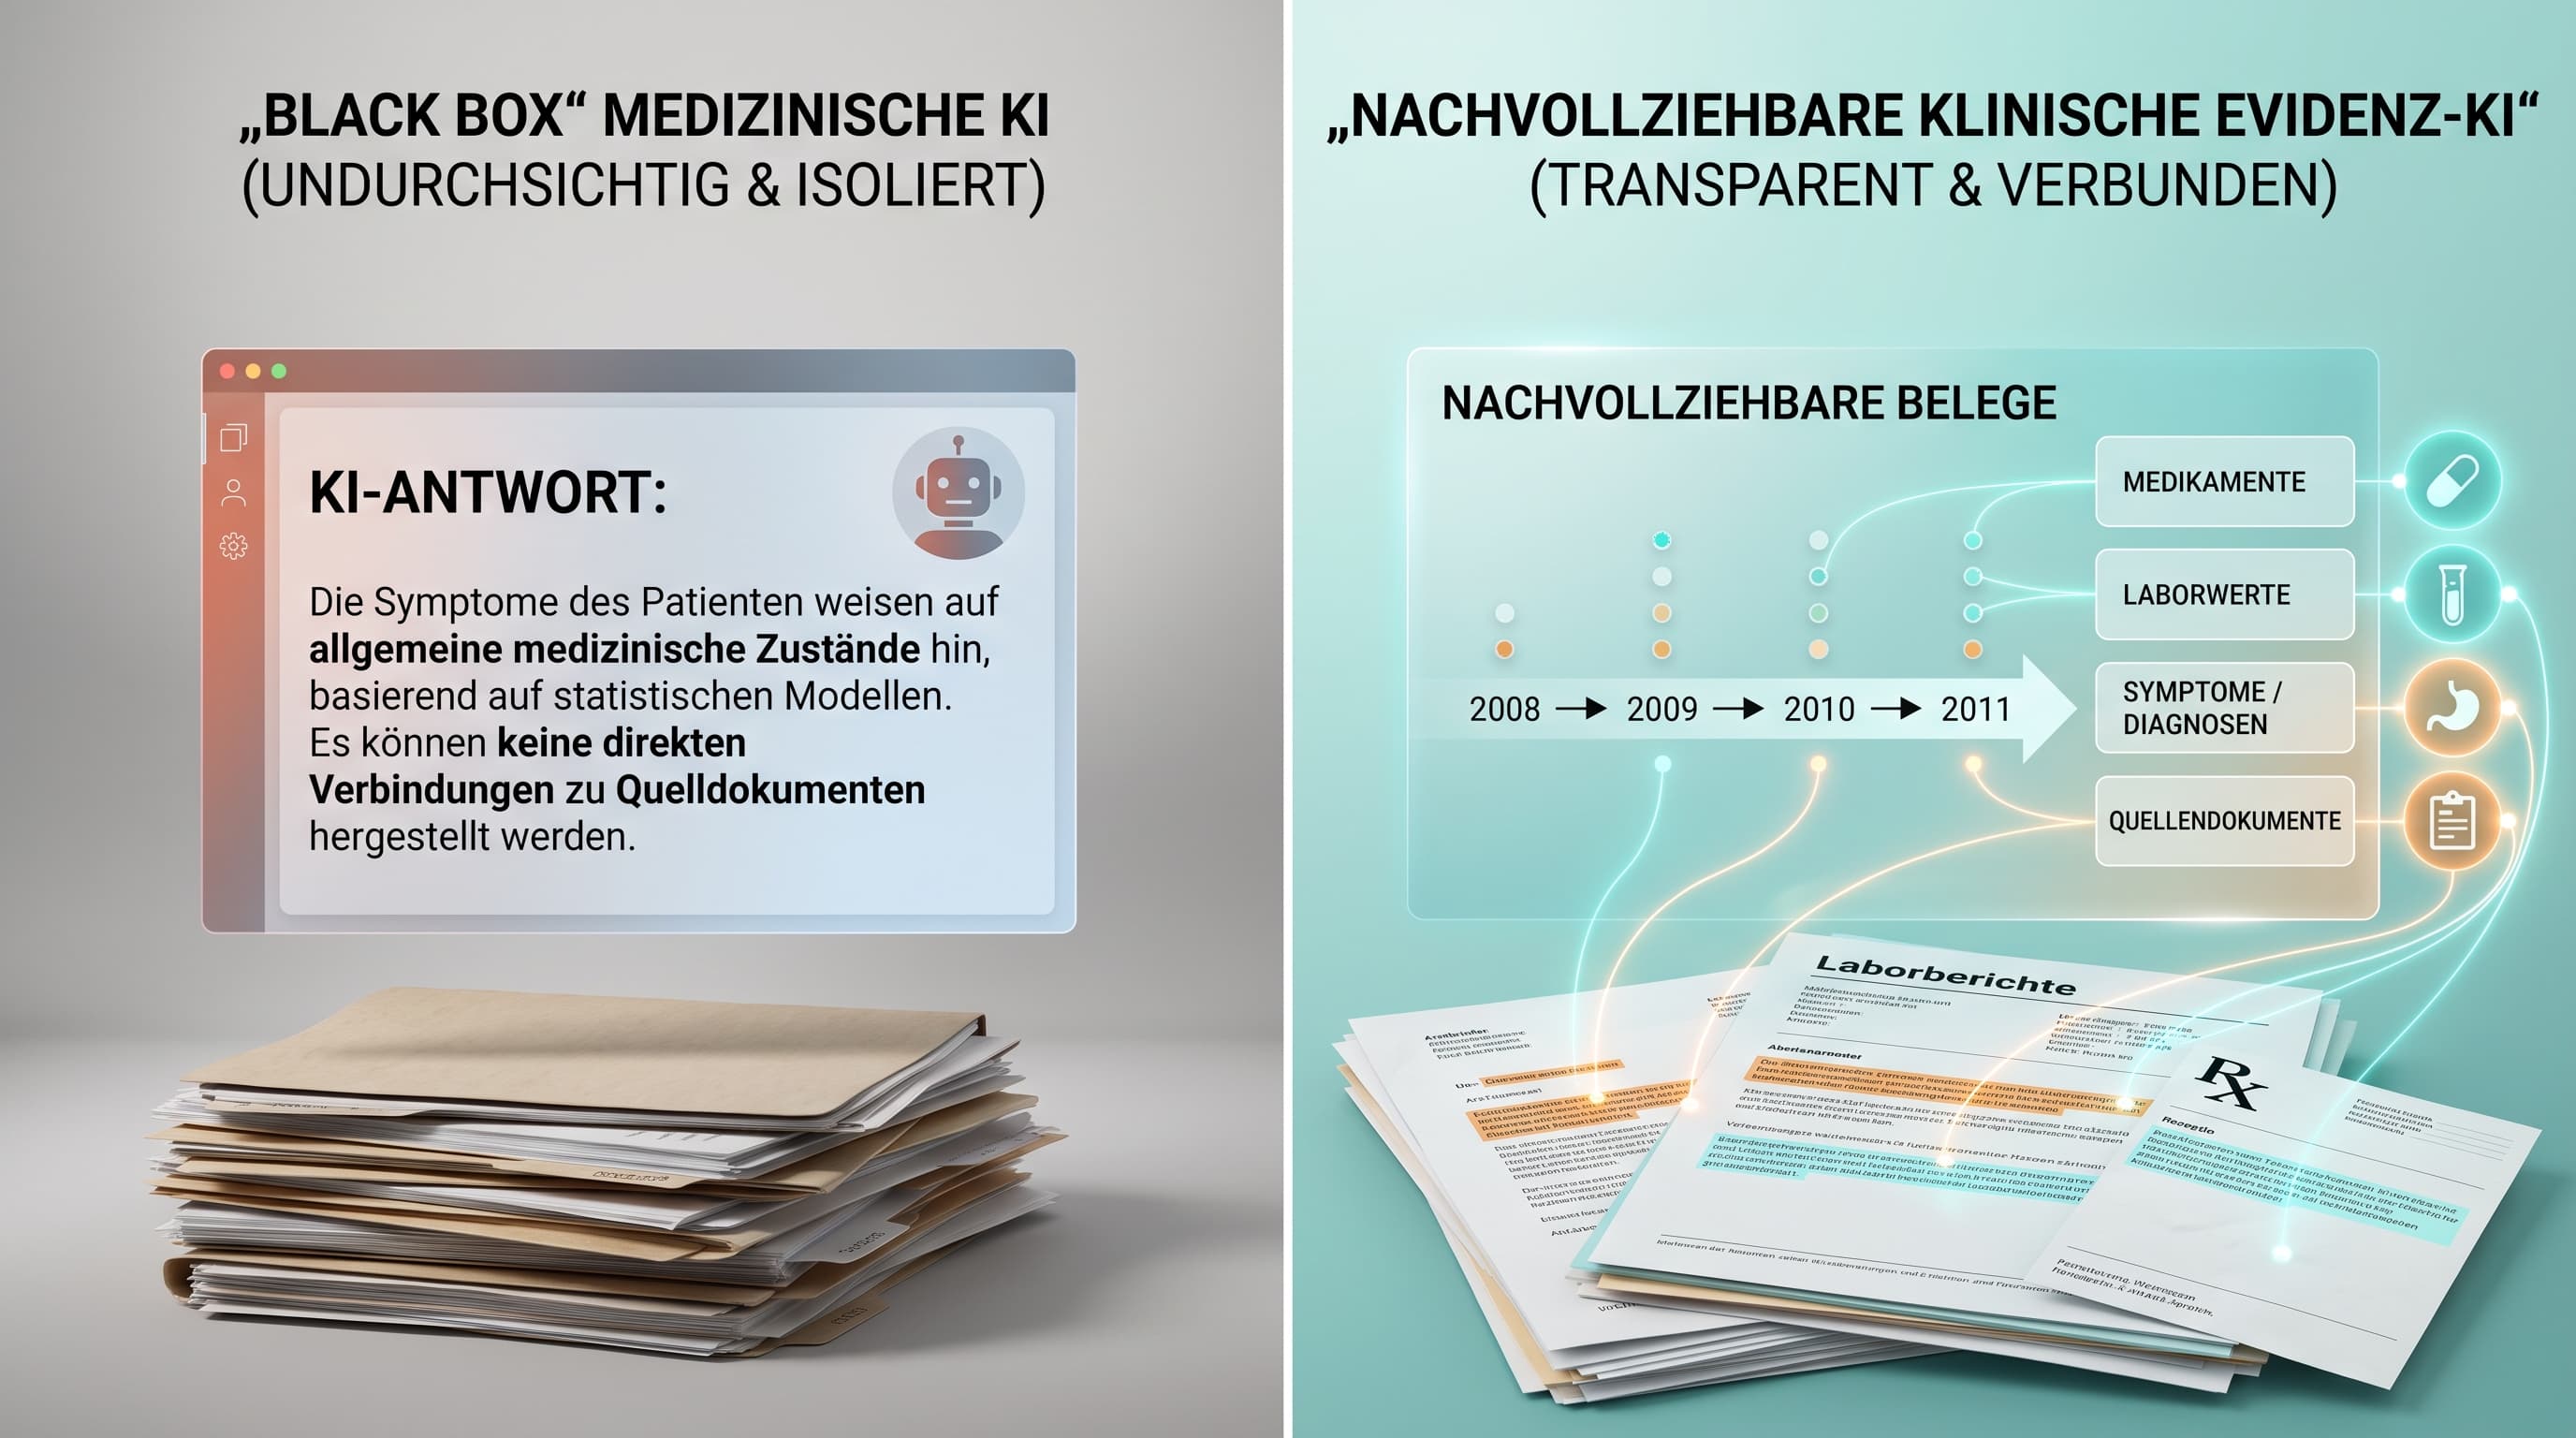
Von Dokumenten zu nachvollziehbaren Fakten: erste Beobachtungen
Das Ausgangsmaterial besteht aus echten medizinischen Dokumenten, teils als digital vorliegende Texte, teils als Scans: Arztbriefe, Laborberichte, Rezepte, Medikamentenpläne und Exporte aus Praxisverwaltungssystemen.
Nach Sichtung des Materials entschieden wir als Erstes, vier Haupttypen medizinischer Informationen zu extrahieren und zu strukturieren: Diagnosen, Medikamente, Laborwerte und Symptome.
Jeder extrahierte Eintrag enthält die entsprechenden Attribute: Ein Laborwert umfasst den Wert, die Einheit und den Referenzbereich; ein Medikament enthält den Wirkstoff, die Dosierung und den Status; eine Diagnose kann bestätigt oder ausgeschlossen werden. Und jede Entität erhält zwei Angaben, auf denen die gesamte Lösung beruht: Datum und Quelle.
Ein vereinfachter Datensatz sieht wie folgt aus:
Patient → HbA1c → 6,3 % → 29. Okt. 2009 → Belegstelle → Quelldokument
Wenn dieselbe Diagnose in sechs Dokumenten vorkommt, behalten wir die einzelnen Vorkommen bei, jeweils mit Datum und Quelle.
Schnell kommt viel zusammen
Unser Forschungskorpus war nach Produktionsmaßstäben klein: neun Patienten.
| Patienten | 9 |
| Dokumente | ~1.455 |
| Faktenvorkommen | 7.544 |
| Thesaurus-Konzepte | 1.664 |
Diese Zahlen zeigen, warum das Problem schnell über die reine Dokumentensuche hinausgeht: Schon eine kleine Anzahl von Patienten erzeugt Tausende einzelner Informationspunkte, die sich wiederholen und überschneiden.
Die Schwierigkeit besteht also nicht mehr darin, welches Dokument relevant ist, sondern, welche Vorkommen zusammengehören, was wann passiert ist, welche Version aktuell ist und welche Dokumente sie belegen.
Von Vorkommen zu nutzbaren Patientendaten
Wir gehen diese Herausforderungen mit einer Lösung an, die einzelne Erwähnungen in Dokumenten in strukturierte, nachvollziehbare Patienteninformationen umwandelt. Die wichtigsten Schritte sind:
- Datenaufnahme heterogener Dokumente (Indexer)
- Extraktion medizinischer Fakten (Enricher)
- Normalisierung von Konzepten und Aggregation von Vorkommen (Thesaurus + Patientengraph)
- Erhalt von Attributen, Zeitangaben und Herkunft (Evidence-Postprocessing)
- Strukturierung der Nutzerabsicht und Aufbau eines abfragespezifischen Kontexts (Query-Rewriter)
- Darstellung von Belegen, Zeitleisten und Quelldokumenten (Searcher + UI)
Sprachmodelle sind an mehreren dieser Phasen beteiligt. Das für den Arzt bestimmte Ergebnis bleibt mit den bereits in der Patientenakte vorhandenen Informationen verknüpft.
Der Thesaurus wächst mit den Daten
Neben der Extraktion ist die Normalisierung eine der zu lösenden Herausforderungen. Ein Dokument kann enthalten:
- DM2
- Diabetes mellitus Typ 2
- Typ-2-Diabetes
während ein Nutzer einfach nach „Diabetes“ sucht.
Es gibt zahlreiche medizinische Terminologien, wie LOINC, SNOMED CT, ICD-10-GM und ATC. Sie sind nützliche Ankerpunkte, decken jedoch nicht alle Oberflächenformen und Abkürzungen ab, denen wir in realen Dokumenten begegnen, und auch nicht das korpusspezifische Vokabular. Daher verknüpfen wir unsere Konzepte, wo immer möglich, mit diesen Standards, bauen aber gleichzeitig einen kundenspezifischen Thesaurus aus den Dokumenten selbst auf.
Wenn die Pipeline auf eine neu extrahierte Entität stößt, sucht sie zunächst nach einem bestehenden Konzept. Findet sie eine passende Übereinstimmung, wird der neue Ausdruck zu einer weiteren beobachteten Form dieses Konzepts. Andernfalls erhält ein lokales Sprachmodell den relevanten Kategorieausschnitt des Thesaurus und entscheidet, ob der Ausdruck zu einem bestehenden Konzept gehört oder ein neues benötigt wird.
Auf diese Weise spiegelt der Wortschatz die tatsächliche Sprache des Korpus wider.
Thesaurusschwächen
Die automatisierte Normalisierung weist folgende gegensätzliche Schwächen auf.
- Übergeneralisierung: zwei miteinander verbundene Konzepte werden zusammengeführt, obwohl sie getrennt bleiben sollten.
- Untergeneralisierung: zwei Ausdrücke, die zusammengehören, landen in getrennten Konzepten.
Und wie bei den meisten groß angelegten automatisierten Pipelines schleicht sich etwas Rauschen in die Struktur ein. Dennoch erfüllt der Thesaurus nach wie vor eine wichtige Aufgabe: Er reduziert Tausende heterogener Erwähnungen auf einen wesentlich kompakteren Konzeptraum. Die Variation der Oberflächenformen wird so beherrschbar, und der Query-Rewriter erhält einen kleineren Kontext mit einer wesentlich höheren Konzentration an nützlichen Informationen.
Zwei Schritte sind besser als einer
Wir wenden diesen Ansatz in unserer Lösung mehrfach an. Die Prämisse lautet: Bei der Verarbeitung natürlichsprachlicher Texte, seien es Dokumente oder Nutzerqueries, wird es immer Fehler geben. Wir bauen das System so auf, dass es diese Fehler später abfängt. Nahezu perfekte Extraktion und Normalisierung sind attraktive Ziele, aber echte Dokumentensammlungen machen es schwierig, diese konsistent zu erreichen – ganz gleich, ob die Methode regelbasiert ist, klassisches maschinelles Lernen nutzt oder auf einem LLM basiert.
Anstatt bei der Datenaufnahme (Ingestion) nach Perfektion zu streben, gliedern wir die Arbeit in Phasen.
Bei der Normalisierung akzeptieren wir bei der Datenaufnahme einen groben Thesaurus und überlassen dem Query-Rewriter einen zweiten Blick. Ein Beispiel: Während der Datenaufnahme landen „Hypertonie“ und „Bluthochdruck“ als zwei getrennte Konzepte in der Sammlung extrahierter Fakten. Zur Abfragezeit sucht der Query-Rewriter nach verwandten Konzepten, und beide Synonyme werden in den Suchplan aufgenommen.
Die finale OpenSearch-Abfrage wird dann deterministisch aus dem strukturierten Plan erstellt, den der Query-Rewriter vorschlägt. Das hat eine nützliche Eigenschaft: Ein Fehler bei der Datenaufnahme bleibt lokal begrenzt.
Das ist eine der interessantesten Erkenntnisse aus dem Projekt: Eine Zwischenrepräsentation kann Fehler enthalten und dennoch das Gesamtsystem verbessern, solange spätere Phasen unter Berücksichtigung dieser Fehler konzipiert werden.
Denselben Ansatz, eine komplexe Aufgabe in zwei Verarbeitungsschritte zu zerlegen, verwenden wir auch bei der Extraktion.
Schritt 1: die rohen Erwähnungen, also wörtliche Zitate, finden und ihren Belegtext beibehalten, z. B. 25.08.2022 Gew. 113,0 kg, RR 160/90 mmHg, BZ pp 10,3
Schritt 2: Zuordnung jedes Zitats zu einer Schema-Zeile:
| Name | Wert | Einheit | Datum |
|---|
| Blutdruck (RR) | 160/90 | mmHg | 2022-08-25 |
| BZ pp | 10,3 | – | 2022-08-25 |
| Gewicht | 113,0 | kg | 2022-08-25 |
Bei den Dokumenten mit der höchsten Messdichte steigerte diese einfache Aufteilung den Labor-Recall um bis zu 40 Prozentpunkte.
Die Fragen bestimmen, wie wir suchen
Manche Fragen wie „Gibt es bei dem Patienten irgendetwas zum Thema Diabetes?“ sind weit gefasst und daher einfach; fast jede Suche findet die richtigen Dokumente.
Die interessanten Fragen sind spezifisch:
- Wie hat sich der HbA1c-Wert im Laufe der Zeit verändert?
- Welche Medikamente sind für diesen Patienten dokumentiert, und wann?
- Welche Belege stützen diese Diagnose?
- Was ist zwischen Januar und Juni aufgetreten?
Diese Fragen erfordern explizite Beziehungen zwischen Konzepten, Vorkommen, Werten, Daten und Quellen. Wiederholte Nennungen müssen zusammengefasst werden. Der Zeitpunkt eines klinischen Ereignisses muss vom Dokumentdatum getrennt bleiben. Und der wichtigste Punkt ist die Vollständigkeit: Wir benötigen jedes relevante Vorkommen, dedupliziert und oft in chronologischer Reihenfolge.
Genau das bietet uns die angereicherte Faktenbasis. Wir bezeichnen diese interne Struktur als Patientengraph. Er enthält alle extrahierten Fakten zu einem Patienten, jeweils verknüpft mit Datum, Belegstelle und Quelldokument. Der Graph ist der Kontext, auf dessen Grundlage wir die Abfragen und Zeitleisten erstellen.
Einige Beispiele
Ein Arzt fragt: „Wie hat sich der HbA1c-Wert entwickelt?“
Der Query-Rewriter erkennt zwei Dinge: ein Laborkonzept und einen Zeitbezug. Die Suche liefert alle normalisierten HbA1c-Vorkommen des Patienten.
Dieselben Fakten bilden nun die Grundlage für zwei Ansichten: eine Zeitleiste und eine Belegliste der einzelnen Vorkommen.
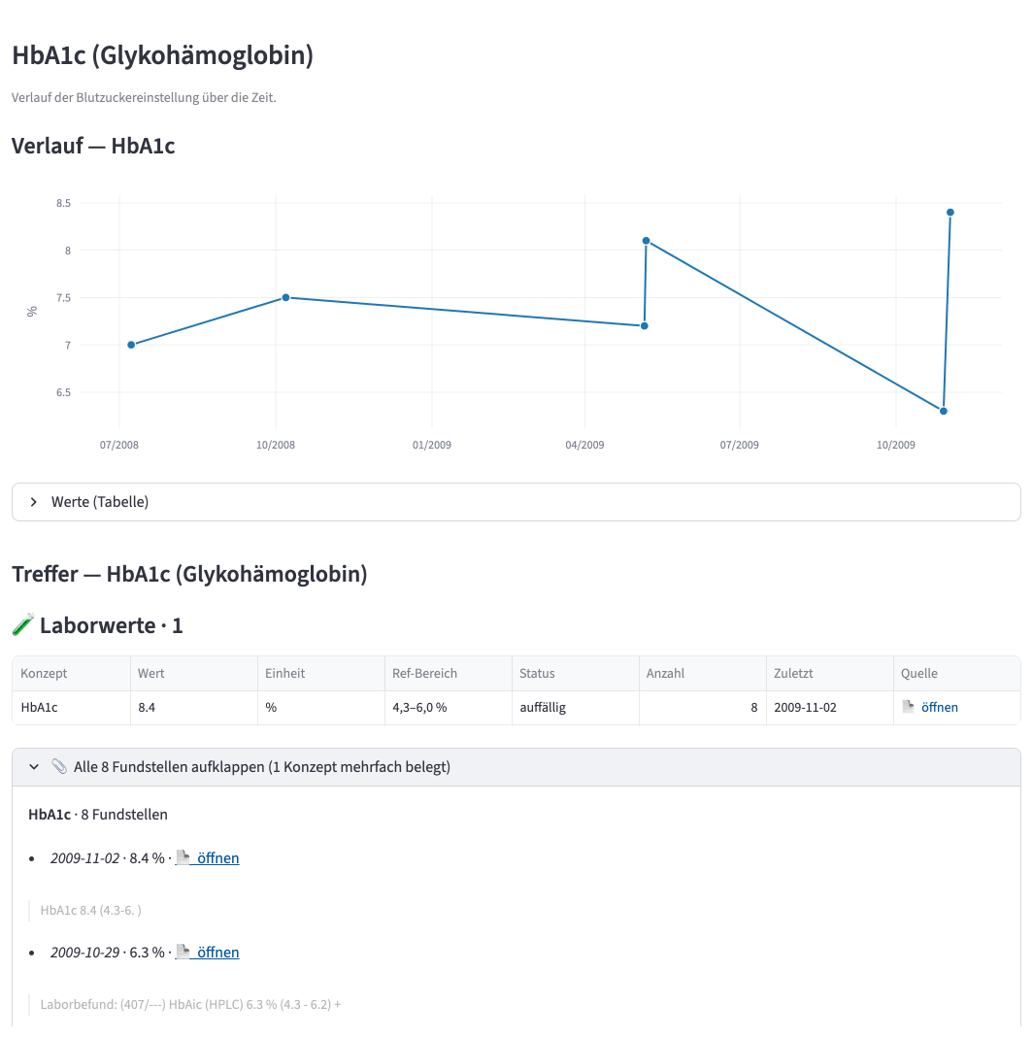
HbA1c im Zeitverlauf: die Zeitleiste aller Vorkommen mit Datum und Wert, darunter der Anfang der Belegliste mit dem wörtlichen Belegtext. Vorkommen ohne lesbaren Wert oder ohne Datum fehlen in der Grafik, bleiben aber in der Liste.
Klickt der Arzt auf ein Vorkommen, gelangt er zurück zum Quelldokument.
Ein Symptom und was dahintersteckt
Ein Arzt fragt nach einem Symptom, zum Beispiel: „Warum ist diesem Patienten schwindelig?“ Der Query-Rewriter beantwortet die Frage nicht. Er erkennt Schwindel als Anker und ruft die Konzepte aus dem Patientengraph ab, die damit verbunden sind: blutdrucksenkende Medikamente, dokumentierter niedriger Blutdruck, eine diabetische Nervenkomplikation. Dann stellt er für jedes die Belege bereit. Nichts wird erfunden, jeder Kandidat stammt aus den Unterlagen des Patienten selbst.
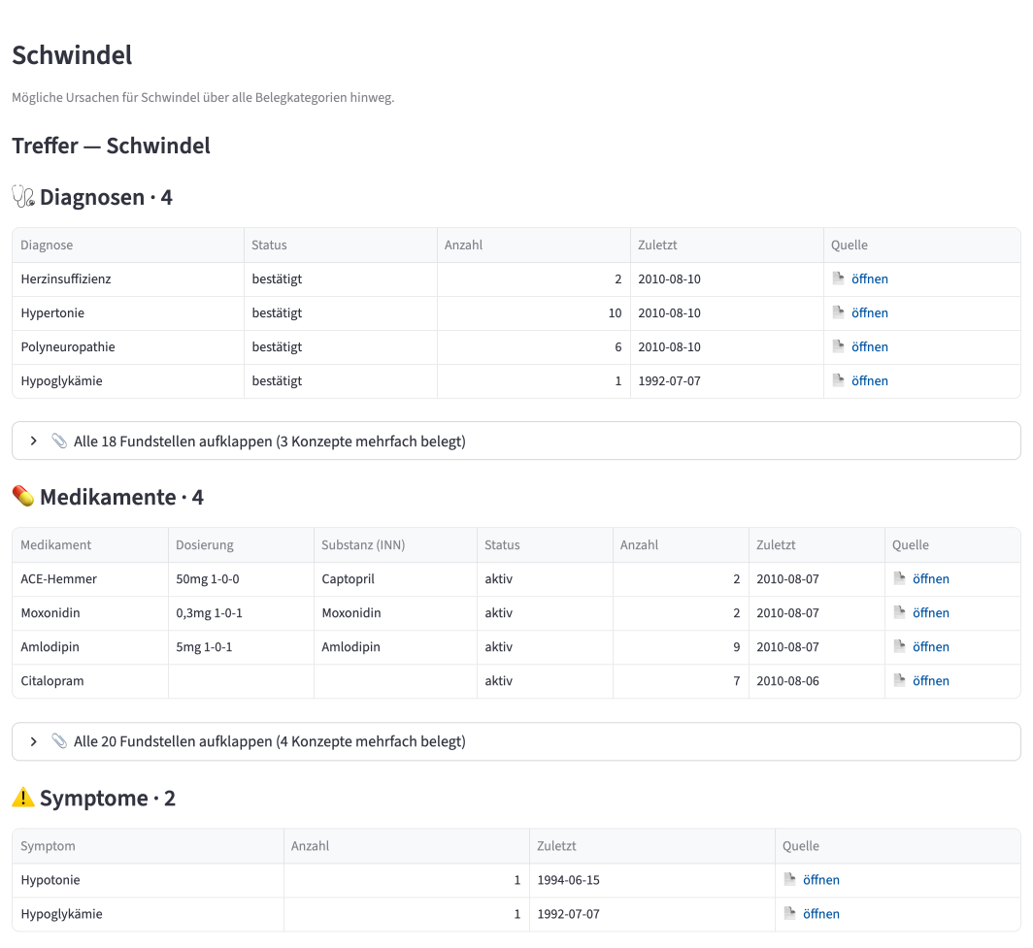
Symptomabfrage „Warum ist diesem Patienten schwindelig?“: verwandte Diagnosen, Medikamente und Symptome aus der Akte, jeweils mit Anzahl und Link zur Quelle.
Einige der gelieferten Begründungen:
- Hypotonie (Symptom): orthostatischer oder chronisch niedriger Blutdruck, eine häufige Ursache von Schwindel, besonders zusammen mit blutdrucksenkenden Medikamenten.
- Amlodipin (Medikament): ein Calciumantagonist, dessen gefäßerweiternde Wirkung den Blutdruck senken und Schwindel verursachen kann.
Zusammengelesen geben beide dem Arzt konkrete Anhaltspunkte: Der Patient nimmt blutdrucksenkende Medikamente, und niedriger Blutdruck ist in der Akte dokumentiert. Das System stellt keine Diagnose: Es bietet in der Akte verankerte Kandidaten mit ihren Belegen an, und der Arzt entscheidet, ob sie das Symptom erklären.
Was wir aus der Forschung gelernt haben
Echte Dokumentensammlungen liefern unvollkommene Zwischendaten. Die Aufteilung in Phasen hält die Suche flexibel: Der Query-Rewriter kann patientenspezifischen Kontext nutzen, um Konzepte wieder miteinander zu verknüpfen, die bei der Datenaufnahme getrennt wurden, und die bereits verfügbaren strukturierten Beleginformationen besser auszuschöpfen. Das Ergebnis bleibt überprüfbar, da jeder für den Arzt sichtbare Eintrag weiterhin mit seinem Beleg und seiner Quelle verknüpft ist.